ROBOTICS · WEIGHT EDITING · AUTORESEARCH

我们让 Opus-5.5 修改 π0.5 的权重,AutoResearch 让它成为现实。

两个发现:通过 RoPE 让机器人动作更快,以及一个意外发现的 RTC 前缀 bug。

Ziyang Gong1,2 · Kaifeng Zheng1,2 · Yingrui Huang1 · Wendi Chen1,2 · Jiaguo Tian1,2 · Junkai Yang1,2 · Minghuan Liu1 · Zhenjie Yang3
1 Shanghai Innovation Institute2 Shanghai Jiao Tong University3 The University of Hong Kong

一个 Frontier Model,一个机器人策略。
两处权重修改。

One Frontier ModelOpus 5.5
One robot policyπ₀.₅
One GPURTX 4090
~111 minutes离线自主研究
−12.0%40 Hz 平均夹瓶子用时 · 17.99 → 15.83 s
−89.8%30/35/40 Hz 平均 chunk 跳变 · 30.88 → 3.14 mm

最近的 Weight Editing 进展让我们好奇:当 Frontier Model 尝试直接修改一个已训练机器人策略的权重时,它会如何找到有效的改法?我们将任务交给 Opus-5.5:通过修改权重,让机器人执行得更快。它展开了一段提出假设、实验验证、根据失败修正方案的 AutoResearch 过程。

Opus 从 RoPE 出发,提出动作位置可能影响运动节奏的假设,设计实验验证,再将有效干预拟合进 Q/K 权重。它还意外发现了前缀处理中的 bug,并把修复写入时间调制权重。我们随后进行夹瓶子任务的真机验证:在原版与编辑版成功率均为 100% 的情况下,编辑版在动作执行频率为 30、35、40 Hz 时,均比同频率原版更快,平均用时分别缩短 4.3%、7.4%、12.0%。三档频率等权汇总后,平均 chunk 跳变从 30.88 mm 降至 3.14 mm,降低 89.8%。当然,随着执行频率提高,跳变的改善幅度也逐渐降低:从 30 Hz 的 94.5%,降至 35 Hz 的 90.7% 和 40 Hz 的 85.2%。

Opus 的确展现了对参数空间的良好理解。但我们认为,这些修改的成功,不仅依赖于参数编辑本身,更大程度依赖于它发现问题、设计实验、解决问题的 AutoResearch 能力。

随后,我们在 YAM 上验证

30、35、40 Hz:原版与编辑版对比。

30 Hz−4.3%平均用时

22.42 → 21.46 s

35 Hz−7.4%平均用时

19.43 → 17.99 s

40 Hz−12.0%平均用时

17.99 → 15.83 s

30 Hz → 40 Hz−29.4%平均用时 · 原版 → 编辑版

22.42 → 15.83 s

权重修改 + 提高动作执行频率
本组实验两者成功率均为 100%

同一布局,每组 3 次执行。上方展示平均完成时间,原版 → 编辑版。视频先对比原版 30 Hz 与编辑版 40 Hz 的全部三次执行,再展示 30、35、40 Hz 各自的同频率对比,各选取原版完成时间居中的一次与编辑版最快的一次。

上排:原版 TT-RTC下排:联合编辑
1× 原速播放。0:00:原版 30 Hz 对比编辑版 40 Hz(三列为三次执行);0:23 起:同频率对比(三列依次为 30、35、40 Hz)。每段均从正式 rollout 开始对齐,各路在第四瓶放手时定格,计时显示该次执行的实际用时。

其他任务:硬币抓取后至交接放手阶段缩短 20.7%;叠方块未见明显提速。这是一次有效、但收益有限的初步尝试。

FINDINGS / Opus 发现了什么

两处权重修改:一次提速,一个意外的 bug 修复。

一个在 Training-Time RTC 官方公开实现中未处理的前缀 bug,一种调节动作节奏的 RoPE 干预。Opus 将两者写入新权重,保留原有生产推理代码。

1 × RTX 4090全程离线研究无真机交互
01 / PREFIX REPAIR意外发现

Training-Time RTC 官方实现中,
未处理的前缀 bug。

每轮去噪前,条件前缀都会恢复为给定动作;但最后一轮仍用预测的 velocity 再更新一次,随后直接返回,没有再次恢复前缀。这里的 velocity 是 flow matching 的生成更新量,不是机械臂物理速度。实际延迟短于预留前缀时,被改写的动作就可能进入执行。官方固定延迟示例丢弃整个前缀,因此没有暴露这一问题。

Opus 如何修改时间调制权重

  1. 先确定零更新目标

    将 scale 设为 −1,消去动作特征的影响;再求 shift = s*,使它经过原动作输出层后为零。

    s∗Wout+bout=0
  2. 让改变量只在 t = 0 生效

    以目标调制值减去原值,得到 d。利用时间特征 cₜ 求解 u:前缀启用 d,其他十个采样时刻不启用。

    c0u=1,ctu=0
  3. 把增量写入 W

    用外积得到 ΔW。因为 cₜΔW = (cₜu)dᵀ,固定的权重增量就包含了按时间启用的效果。

    ΔW=udT,W′=W+ΔW

等效代码修改:一行前缀恢复操作

修改前 · 源码节选(省略处已标记)
guided, model_input, time = sampling_input(x, target, omega, sigma, config)
return guided - predict_velocity(model_input, time) / num_steps
# ...
return jax.lax.fori_loop(0, num_steps, step, noise)
等效代码修改 · 一行恢复前缀
actions = jax.lax.fori_loop(0, num_steps, step, noise)
actions = omega * target + (1 - omega) * actions
return actions

核心修复只需一行:采样循环结束后恢复条件前缀。对 0/1 硬掩码,高亮行等价于 actions[:, :6] = target[:, :6];其余两行用于接收和返回结果。这是等效代码对照。Opus 实际交付的是让前缀更新量接近零的新权重,生产推理中没有新增这行操作。

展开实际权重修改代码 · 闭式求解
原脚本 K 对应本文 W;原脚本 W 对应本文 W_out
u = np.linalg.lstsq(A, rhs, rcond=1e-10)[0]
s_star = -np.linalg.lstsq(W.T, bo, rcond=None)[0]
d = np.concatenate([-1. - scale0, s_star - shift0, np.zeros(1024)])
dK = np.outer(u, d)
K2 = K + dK

A 堆叠时间特征,rhs 选择前缀,scale0/shift0 是原调制值。只改 K,动作输出权重 W 与推理代码保持不变。

离线切换步长(中位数)

原版19.16 mm权重修复1.80 mm代码修复1.88 mm

结论:在相同离线输入上,权重修复与一行代码修复将切换步长降至近似水平。Opus 识别了前缀一致性问题,并通过修改最终归一化层的时间调制权重,近似实现了这一修复。

02 / RoPE TEMPO ACCELERATION动作节奏 → 权重

增大 RoPE 位置间隔,
再把干预效果写入权重。

Opus 将模型内部的动作位置从 P + i 改为 P + si,保持 30 Hz 执行频率。s = 1.25 时,离线路径进度比的中位数为 1.131,路径偏差为 1.229 mm。

action_positions = P + 1.25 * i

已有离线对照:间隔更大,不一定更好

路径进度比 ↑
0虚线:原版 = 1s=0.8: 0.851 ×0.8510.8s=1.25: 1.131 ×1.1311.25s=1.5: 1.175 ×1.1751.5s=2.0: 1.009 ×1.0092.0RoPE 位置尺度 s
路径偏差(mm)↓
0s=0.8: 0.793 mm0.7930.8s=1.25: 1.229 mm1.2291.25s=1.5: 1.935 mm1.9351.5s=2.0: 4.674 mm4.6742.0RoPE 位置尺度 s

直接 RoPE 干预 · 60 个观测中 58 个有效 · 跨观测中位数。绿色柱为选定的 s = 1.25。这里衡量预测路径,不是真机完成速度。

把 RoPE 干预效果,拟合进 Q/K 权重。

将位置干预作为 teacher,Opus 构造旋转后的 Q/K 目标,求解第 1–17 层的新投影权重,让候选模型沿用原推理代码与位置规则。

位置干预 → 等效旋转 → 权重拟合

下列为简化伪代码。RoPE 前的 Q/K 额外旋转与 teacher 的位置修改在代数上等价;共享投影权重对该旋转的拟合只是近似。

原版
q = X @ Wq
k = X @ Wk
Q = rope(q, P + i)
K = rope(k, P + i)
Teacher · 修改位置规则
q = X @ Wq
k = X @ Wk
Q = rope(q, P + 1.25 * i)
K = rope(k, P + 1.25 * i)
候选 · 只替换权重
q = X @ Wq_fit   # new weights
k = X @ Wk_fit   # new weights
Q = rope(q, P + i)  # original positions
K = rope(k, P + i)

Opus 如何构造 Y、拟合 ΔW

  1. 收集隐藏特征 X

    用本地 demonstration 与历史 rollout 的观测运行模型,将各层 Q/K 投影前的隐藏特征逐行堆叠为 X。

    Q/K0=XW0
  2. 旋转原版 Q/K,得到目标 Y

    对动作 i,将同一特征产生的原版 Q/K,额外旋转位置差 0.25i 对应的 RoPE 角度,补足 P+i 到 P+1.25i 的差异;将目标向量逐行堆叠为 Y。

    yi=R(0.25i)(W0Txi)
  3. 拟合 W,再减去原权重

    让 XW 接近 Y,同时用正则项限制偏离 W₀。对第 1–17 层的 Q、K 分别拟合;推理保留原版 RoPE。

    Wfit=arg⁡minW[∥XW−Y∥F2+λ∥W−W0∥F2]
ΔW=Wfit−W0,W′=W0+ΔW

离线路径进度比(原版 = 1)

原版1.000×仅节奏加速1.199×路径偏差1.08 mm
文章目录

以下是完整 Blog

摘要

基于模仿学习的机器人策略,其执行速度往往受限于示范数据的执行节奏(Execution Tempo)。然而,任务语义信息、Skill和关键交互具有一定的时间尺度不变性(Temporal Invariance)。例如,人类以 3 倍速或 0.5 倍速观看同一段技能讲解视频,节奏虽然不同,但从中提炼的核心技能知识仍然相同。为此,我们从Frontier Model的weight space出发,探索能否通过parameter adaptation,在保留任务知识与操作能力的同时,实现执行节奏的可控调整,并在满足动力学约束与任务成功率的前提下,提升 closed-loop execution的速度与平滑性。 我们向 Opus 5.5 提供预训练策略、源码、历史轨迹与一张 RTX 4090,要求不使用反向传播、不改变生产推理程序,并交付可回滚的独立权重。它从 RoPE 的机制出发,提出动作位置间隔可能影响预测节奏的假设,设计对照实验加以检验;在输出层拟合效果不佳后,转向注意力 Q/K 投影,将位置干预近似写入权重。它还在未被明确要求的前缀处理细节中发现问题,并通过另一项参数修改缓解 chunk 跳变。我们随后进行真机验证:放瓶子任务在 30、35、40 Hz 下的平均完成时间分别比同频率原版缩短 4.3%、7.4%、12.0%,三档频率等权汇总的平均 chunk 跳变降低 89.8%;注意力区域干预进一步显示,动作之间的分数变化保留了较多离线进度收益。这些结果提供了初步的有效性证据,而本文更关注形成方案的研究过程:机制理解、假设提出、实验设计与失败后的方法修正如何共同构成 Weight-Space Editing。这个案例让我们得以具体讨论以及掀开未来的一角,Frontier Model 将会以什么形式参与具身领域问题的发现与解决。

1 我们的想法与研究条件#

我们想检验:Frontier Model 能否理解一个已训练机器人策略的参数,并通过少量修改让机器人更快地执行动作、完成任务?我们将这个问题交给 Opus 5.5,让模型根据机制与目标推导权重修改。

我们提供目标与环境,由 Opus 5.5 提出假设、设计实验并选择解法。环境包括一张 NVIDIA GeForce RTX 4090、已训练的 π0.5 [2] Training-Time RTC checkpoint、模型与推理源码、本地 demonstration 和历史机器人执行数据。它通过 Claude Code 调用工具开展离线研究。所用 demonstration 与历史执行轨迹均采自 YAM 机械臂,后续真机验证也由我们在 YAM 上完成。Opus 5.5 的自主研究全程未操控机器人,也未获取在线物理反馈,仅使用已有记录进行离线实验。它统计了136 条历史执行轨迹(5 类任务)与 154 条人类 demonstration(3 类任务);实际编辑另从已有数据中选取 12 条 demonstration(6 类任务)和 12 条历史执行轨迹(4 类任务)。任务包括投硬币、抓移动方块、叠方块、放瓶子和按压旋转时钟。

我们要求不使用反向传播、梯度优化器或 LoRA,允许前向实验和闭式拟合;尽量少改参数,保持生产推理与控制程序不变,并交付独立、可回滚的权重。20%–30% 的任务时间缩短是探索目标,稳定的 5%–10% 改善也有意义;需要检查平滑性和跨任务表现,并与原版、动作幅度缩放、轨迹时间缩放及随机权重修改比较。

实际得到的方案,由机制假设、对照实验和方法修正逐步形成。我们关注的不只是权重修改后的性能,也包括 Opus 如何发现问题、检验解释,并在失败后改变方向。第二节介绍其研究过程,第三节报告我们补充的真机与机制实验,最后讨论这一案例对 Robotics AutoResearch 的启发。

本文中,一个 action chunk 是策略一次预测的 50 步未来动作,每步包含两臂 12 个关节目标与 2 个夹爪目标,采样频率为 30 Hz。每轮执行 32 步,更新计划时将旧计划的前 6 步作为条件,即 RTC prefix。切换前后目标位置的突变称为 chunk 跳变;它描述命令的变化,而非机械臂瞬间移动。

2 Opus 5.5 的假设、验证与解法#

2.1 定位提速对象:推理等待与动作执行#

Opus 5.5 首先检查任务耗时是否主要来自等待模型推理。它读取部署配置,并对照 136 条历史 RTC 轨迹中的推理时间、动作命令和实测关节状态。一次推理约需 105–109 ms,明显短于约 1.073 s 的计划更新周期;记录中也未出现以等待下一次推理为主的明显空窗。随后,它用 154 条 demonstration 中的动作速度与停顿作为参考,转向分析策略生成的动作。

这一诊断将研究重点落在动作执行过程中的时间收益。Opus 5.5 沿两条线索继续验证:首先检查新旧 chunk 切换时的异常是否来自生成过程,再检验能否在保留任务路线的同时增加后续动作的推进量。前者形成前缀修复方案,后者形成节奏加速方案(通过 Q/K 投影编辑实现);两者合并称为联合编辑。

2.2 修复保留动作前缀中的 chunk 跳变#

Opus 5.5 比较模型输出与实际执行命令后发现:前 6 步作为条件输入,但生成结果偏离了这些旧动作;部署通常只裁掉过期的前 4 步,剩余第 5、6 步的偏差便进入执行。原因是最后一次 flow matching 积分后,前缀没有再次恢复。

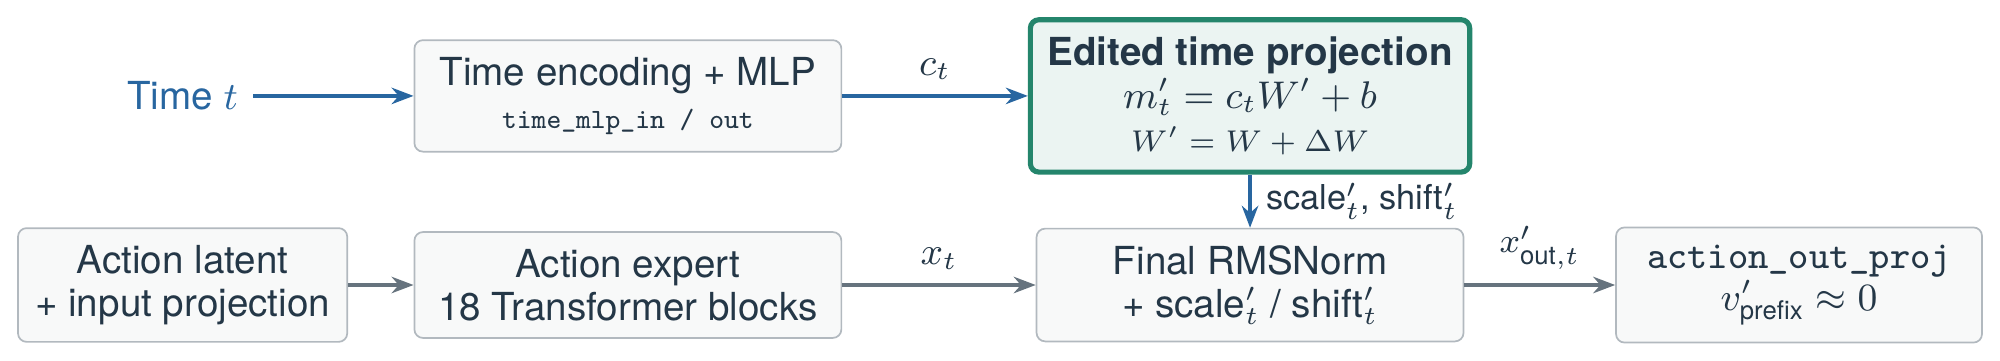
Opus 5.5 计算权重增量矩阵 ΔW,将 W′=W+ΔW 保存到新 checkpoint。Opus 修改的是最终归一化层里,将时间特征映射为 scale、shift 的线性层权重 W(图 1),即 final_norm_1.Dense_0.kernel。ΔW 与它同为 1024×3072,逐项指定权重增量。目标是让前缀更新量接近零,同时保持其他采样时刻的输出;推理代码不变。

前缀修复只将绿色时间投影层改为 \(W'\) 。时间特征 \(c_t\) 在最终归一化处调制动作特征 \(x_t\) ;动作输出投影不变。
图 1. 前缀修复只将绿色时间投影层改为 W′。时间特征 ct 在最终归一化处调制动作特征 xt;动作输出投影不变。

原版时间调制过程如图 1 所示,原版在绿色位置使用 W。前缀使用生成时间条件 t=0,其他动作使用 1.0,0.9,…,0.1;t 不是物理执行时间。时间编码及 time_mlp_in/out 将 t 映射为 1024 维特征 ct,其中 c0 不是零向量。对单个动作 token,令 xt 为它经过 18 层 Transformer 后的隐藏特征;mt 则是时间分支算出的三组调制值。本小节的特征按行向量书写,u,d 为列向量。原版模型通过 scale 和 shift 调整 xt: mt=[scalet,shiftt,gatet]=ctW+b,xout,t=RMSNorm(xt)⊙(1+scalet)+shiftt,vt=xout,tWout+bout.(1) 这组公式是原版已有的计算,Opus 沿用它来推导编辑目标。⊙ 表示逐元素乘法,gate 在此未使用。这里 RMSNorm(x)=x/mean(x2)+10−6,不额外包含可学习的 scale;时间调制已在式中单独写出。Wout,bout 属于线性层 action_out_proj,不是时间 MLP;Wout∈R1024×32,其输出 vt∈R32 是采样更新量。前缀修复保留 b,Wout,bout,只替换 W。

第一步:设定能让前缀更新量为零的目标。以下带撇号的量表示编辑后。Opus 将 scale 的目标设为全 −1,再求最小范数的 s∗,使它经线性动作输出层后为零: scale0′=−1,shift0′=s∗,s∗Wout+bout=0,xout,0′=RMSNorm(x0)⊙0+s∗=s∗,v0′=0.(2) 因此不需要令 Transformer 的输出 x0 本身为零;目标 scale 会消去它的影响,目标 shift 则令最终特征等于 s∗,并抵消输出层偏置。

第二步:计算调制值的目标改变量。以目标减原值,得到 dT;加回原调制值即可检查它是否达到目标: dT=[−1−scale0, s∗−shift0, 0],m0+dT=[scale0,shift0,gate0]+dT=[−1,s∗,gate0].(3) 第三步:求解 u,使增量只作用于前缀。Opus 将 10 个采样时刻的时间特征与前缀 t=0 的时间特征逐行堆叠,组成 A∈R11×1024。它要找 1024 维系数 u,使前缀的点积 c0u=1,其余十个点积 ctu=0。把这些目标组成向量 r,统一求解: A=stackrows(c0,c1.0,c0.9,…,c0.1),r=(1,0,…,0)T,u=argminz∥Az−r∥22(minimum-norm solution).(4) c0u=1 表示给前缀加上完整的 dT;其余点积为 0 表示不加。c0 来自原模型,u 来自这次求解。

写回权重并检查效果。我们希望时间特征经过新权重后,恰好多出 (ctu)dT。由于矩阵乘法满足结合律,这等于 ct(udT);因此将 udT 作为权重增量即可: ΔW=udT,W′=W+ΔW,Wij′=Wij+uidj,ctΔW=ct(udT)=(ctu)dT,mt′=ct(W+ΔW)+b=mt+(ctu)dT.(5) ΔW 的第 i 行为 uidT:所有行都由同一个向量缩放得到,只有一个独立方向,因此这是一项秩一修改。

在 36 个 demonstration 与 24 个历史执行观测上,前缀关节误差由约 0.095 rad 降至 4.49×10⁻⁴ rad,后续动作最大变化约为 0.0034 rad,路径进度几乎不变。Opus 5.5 因此保留这一前缀修复,继续寻找提速方法;我们对该问题的代码与实验核对见第 3.2 节。

2.3 动作节奏假设与 RoPE 位置干预#

前缀修复没有让后续动作推进得更快。对于提速,Opus 5.5 在读取模型代码时提出:“My leading hypothesis is that action timing depends on RoPE positions.” 我们进一步展开这一假设:模型可能学到了动作位置间隔与动作位移的隐式联系;增大内部位置间隔、保持实际控制周期不变,可能让相同时间内的有效位移增加。

图 2 先概括这一步:改变模型读取动作序列的位置坐标,再检验预测动作是否推进得更快。
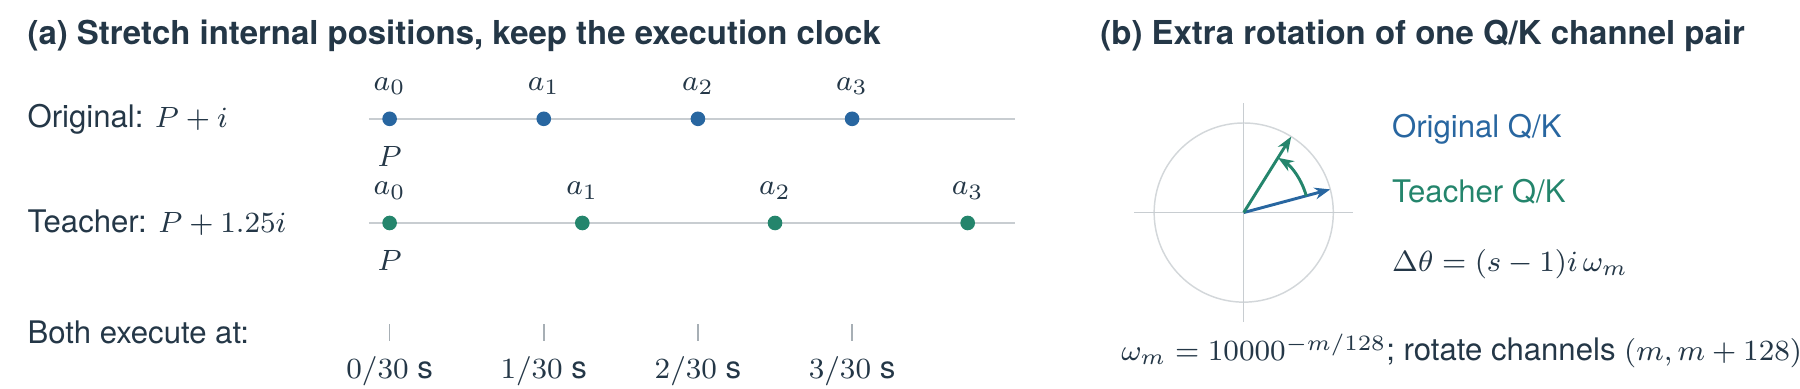
RoPE 位置干预:内部动作位置间隔放大,实际执行时钟不变;对应变化是每对 Q/K 通道的额外旋转。圆图为原理示意。
图 2. RoPE 位置干预:内部动作位置间隔放大,实际执行时钟不变;对应变化是每对 Q/K 通道的额外旋转。圆图为原理示意。

实现:改变动作位置对应的 Q/K 旋转。

令 i=0,…,49 为动作序号、P 为未被 mask 屏蔽的上下文 token 数。这里及后续离线公式的动作索引均从 0 开始。内部位置改变,实际执行间隔 Δt=1/30 s 保持不变: pi=P+i,pi(s)=P+si,tiexec=t0+iΔt.(6) RoPE 将位置编码为 Q/K 的旋转 [3]: qi=WQTxi,ki=WKTxi,Qi=R(pi)qi,Ki=R(pi)ki.(7) xi∈R1024 是经过该层自适应归一化、送入 Q/K 投影的隐藏特征,这里按列向量书写;WQ,WK∈R1024×256 分别表示一个 query head 和共享 key head 的投影权重;实际有 8 个 query heads、1 个 key/value head。在每个 256 维 head 内,第 m 与 m+128 个通道配对旋转,m=0,…,127。对其中一对 (a,b), [a′b′]=[cos⁡θ−sin⁡θsin⁡θcos⁡θ][ab],θ=p10000−m/128.(8) R(p) 表示全部 128 对通道的旋转。固定旋转前的内容向量,动作 i,j 的内积由原版变为 QiTKj=qiTR(j−i)kj,(Qi(s))TKj(s)=qiTR(s(j−i))kj.(9) 因此,干预放大的是动作之间的相对位置间隔。动作 Q 对保持不变的图像、文本和状态 K 的读取也会变化;经过 softmax 和对 V 的加权,影响后续动作生成。它不直接放大 V 或关节目标。

检验:位置干预是否增加沿原路线的推进。

Opus 5.5 执行两组对照:(1)在 36 个 demonstration 观测与 24 个历史执行观测上,将全部 18 层动作位置改为 P+si,测试 s=0.8,1.25,1.5,2.0;(2)在 36 个 demonstration 观测上保持 RoPE 不变,只将提供给模型的前 6 步动作加快至原来的 1.25、1.5、2.0 倍。各干预与原版使用相同观测和初始噪声。

它先将原版预测按不同倍速重采样,寻找与干预后关节轨迹最接近的速度:s=1.25 的 RoPE 干预对应约 1.12 倍,而仅加快前缀对应约 1.01 倍。因此,它继续研究位置干预。

随后,Opus 5.5 检验:在相同预测时刻,编辑版是否沿原版规划的路线走得更远。它进行正向运动学计算,将原版 TCP pose 的位置连成参考路线。将编辑版位置匹配到路线最近点,以该点的累计沿路距离除以原版同一时刻的沿路距离,得到路径进度比;编辑版各位置到路线的最近距离的均值为路径偏差(图 3)。
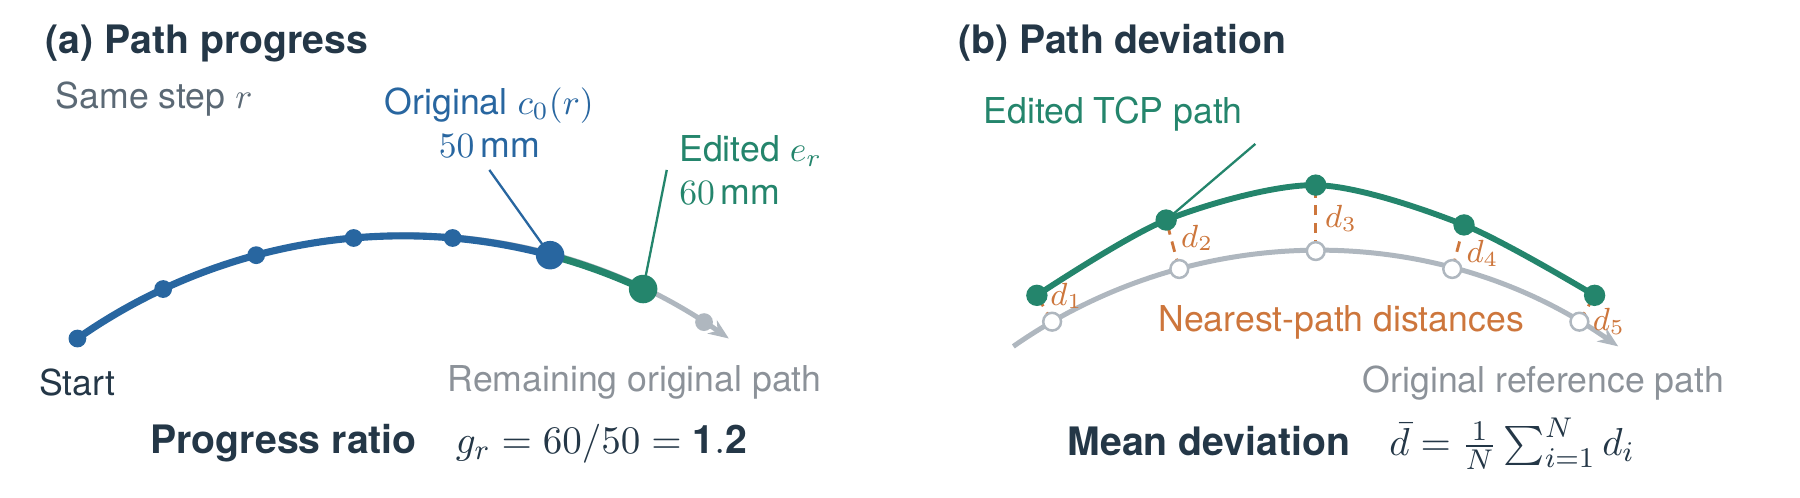
两项路径指标。(a)同一时刻原版推进 50 mm,编辑版对应参考路线上的 60 mm,进度比为 1.2。(b)对编辑位置到参考路线的最近距离取平均,得到路径偏差。
图 3. 两项路径指标。(a)同一时刻原版推进 50 mm,编辑版对应参考路线上的 60 mm,进度比为 1.2。(b)对编辑位置到参考路线的最近距离取平均,得到路径偏差。

计算排除前 6 步条件。令 cref(u) 为原版第 6–49 步线性插值的 TCP 路线(米),Lref(u) 为从第 6 步到 u 的累计沿路距离,er 为编辑版第 r 步的位置。进度只在 r=21,37 处评估;偏差使用 I={6,…,37} 中全部位置。与代码一致,进度在网格 Up={6+0.01k:k=0,…,4300} 上寻找最近点,偏差在 [6,49] 的 880 个等距点 Ud 上计算: ur∗=arg⁡minu∈Up∥er−cref(u)∥2,r∈{21,37},gr=Lref(ur∗)max{Lref(r),10−9},d¯=1000|I|∑r∈Iminu∈Ud∥er−cref(u)∥2.(10) 其中分母下限为 10−9 米,用于避免参考路程为零时除零;d¯ 中的 1000 将米换算为毫米。 表 1 报告 g37 与 d¯(mm)。原版在比较区间内移动不足 15 mm 的手臂不纳入;每个观测内平均有效手臂,再跨观测取中位数。

表 1. 位置尺度与前缀加速对照。Opus 5.5 保存逐样本指标,我们按有效观测取中位数;RoPE 组为 60 个输入中的 58 个,前缀组为 36 个中的 34 个。

干预 尺度 纳入统计的观测数 路径进度比 路径偏差
动作 RoPE 0.80 58 0.851 0.793
动作 RoPE 1.25 58 1.131 1.229
动作 RoPE 1.50 58 1.175 1.935
动作 RoPE 2.00 58 1.009 4.674
RTC 前缀时间压缩 1.25 34 1.004 0.492
RTC 前缀时间压缩 1.50 34 1.004 0.796
RTC 前缀时间压缩 2.00 34 1.007 1.134

表 1 显示,s=1.25 和 1.5 增加进度,2.0 的收益基本消失且偏差增大;仅加快前缀的作用很小。我们推测,固定采样间隔下学到的时间与动作映射,可能使位置缩放的收益存在限度。这是对非单调趋势的解释,尚不是已验证的原因。

Opus 5.5 选择 s=1.25 为主要目标。这个干预改的是动作专家注意力中的位置规则,权重不变。为了保持生产推理代码不变,它将此模型作为直接 RoPE teacher,尝试把干预效果内化到与原版结构相同的新权重中。

2.4 首次尝试:仅拟合末端动作输出层#

要检验的最小改动:仅改最后一层,能否复现 teacher 的最终动作?原输出层为 1024×32,其中前 14 个通道对应双臂关节与夹爪,其余 18 个为填充通道。Opus 5.5 只拟合前 14 列,保留其余列与全部偏置。下面 B∈R1024×14 表示这 14 列,b0∈R14 是对应偏置;AiT,zk,i,vk,i∈R14 均取归一化动作空间中的这 14 个通道。AiT 为 teacher 的最终输出,zk,i 为候选第 k 轮、位置 i 的当前状态;hk,i∈R1024 为经过最终时间调制归一化、送入输出层的列向量,剩余生成时间为 σk=1−k/10: vk,i∗=zk,i−AiTσk,vk,i=BThk,i+b0,zk+1,i=zk,i−0.1vk,i,k=0,…,9,i≥6.(11) v∗ 是朝 teacher 最终动作推进的目标更新量,不是机械臂速度。Opus 5.5 用带原权重正则的最小二乘拟合 B,偏置 b0 固定;采样器迭代 10 次得到最终动作(图 4)。
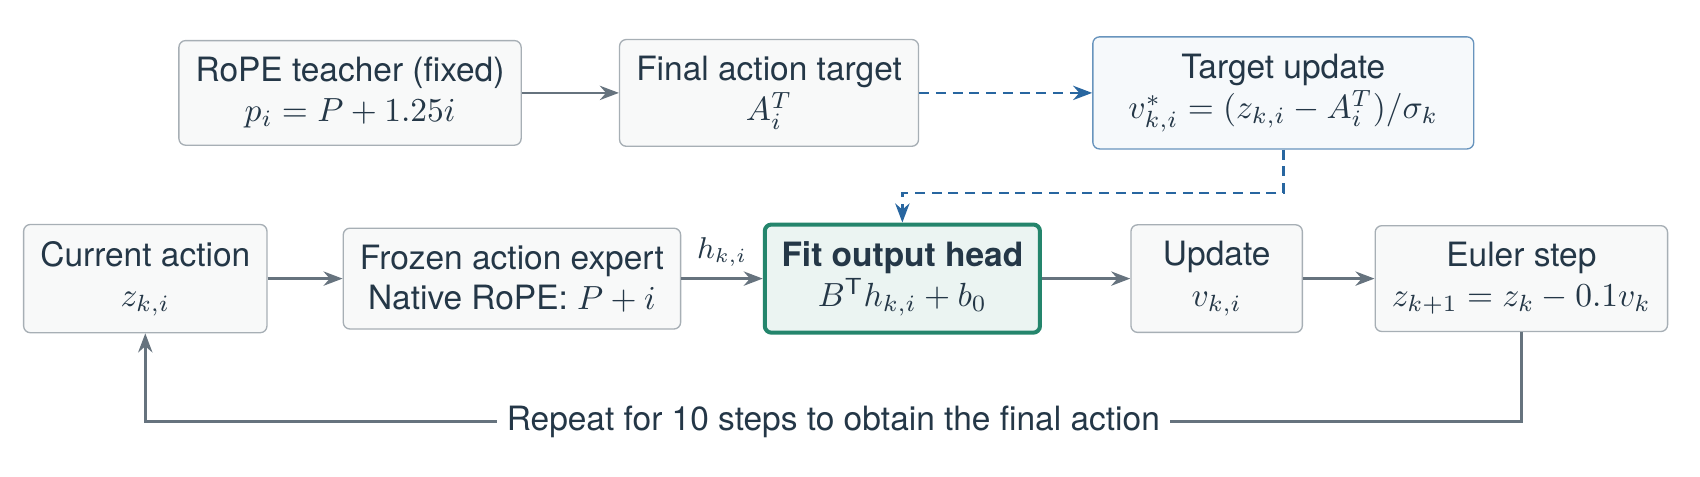
仅拟合绿色输出层,目标由 teacher 的最终动作构造;输出参与 10 步迭代生成。其他权重及原生 RoPE 不变。
图 4. 仅拟合绿色输出层,目标由 teacher 的最终动作构造;输出参与 10 步迭代生成。其他权重及原生 RoPE 不变。

分别检查拟合重建与新输入上的迁移。令 ai,j,ai,jT 为候选与 teacher 的最终关节目标,j 遍历 12 个关节;每个观测的关节误差为 ERMS=132×12∑i=637∑j=112(ai,j−ai,jT)2.(12) 它先平方、平均再开根,以 rad 报告,再对观测取平均。为检查动作是否剧烈变化,对 TCP 位置 pi 计算加速度的变化率 jerk: ji=pi+3−3pi+2+3pi+1−piΔt3,J=129∑i=634∥ji∥22.(13) 报告 Jedit/Jorig,在观测内平均有效手臂;它不包含 chunk 切换,需与路径进度及偏差一起解释。

24 个 demonstration 观测上拟合三轮后,关节 RMS 为 0.0050 rad;另 12 个 demonstration 与 16 个历史执行观测上,误差增至 0.0239 rad,平均路径偏差为 8.256 mm,jerk 比为 3.245。重建效果未延续到测试输入,Opus 5.5 因而放弃输出层拟合,转向注意力内部。

2.5 转向注意力内部:拟合 Q/K 投影#

Opus 5.5 将拟合目标从最终动作移到 Q/K 表示:目标由已知旋转直接计算,再由新权重近似复现(图 5)。
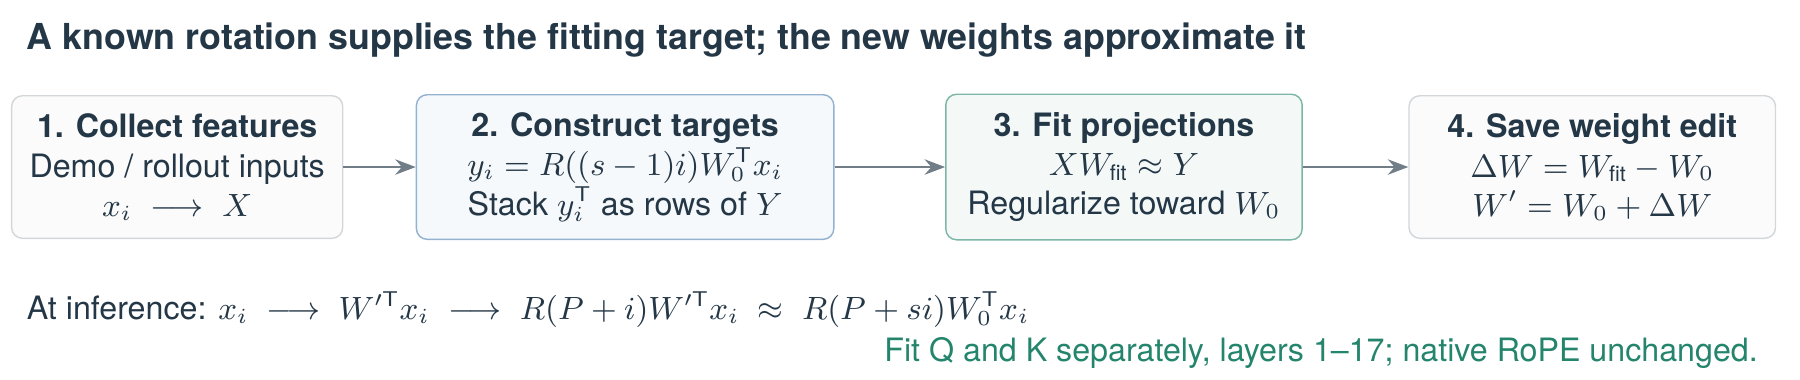
用同一隐藏特征的原版 Q/K 经过额外旋转构造 \(Y\) ,再拟合并保存新权重;推理仍使用原版 RoPE。
图 5. 用同一隐藏特征的原版 Q/K 经过额外旋转构造 Y,再拟合并保存新权重;推理仍使用原版 RoPE。

第一步:构造中间表示目标。要让候选保留原生 RoPE R(P+i),同时近似 teacher 的 R(P+si),需在投影输出中补上额外旋转: R(P+i)R(δi)=R(P+si),δi=(s−1)i.(14) 因此,分别对 Q 和 K 构造目标: yiQ=R(δi)WQ,0Txi,yiK=R(δi)WK,0Txi.(15) 目标 yi 来自同一隐藏特征 xi 的原版 Q/K 加已知旋转,无需更快动作的人工标签。

第二步:采集特征并闭式拟合。Opus 5.5 先检查特征采集前向是否改变原版输出,关节 RMS 为约 0.00037–0.00044 rad,低于采用的 0.002 rad 容差,才将列向量转置,以 xiT、yiT 分别作为一行,堆成 X∈RN×1024、Y∈RN×256,求解 Wfit=arg⁡minW(∥XW−Y∥F2+λabs∥W−W0∥F2)=(XTX+λabsI)−1(XTY+λabsW0),ΔW=Wfit−W0,λabs=λgridtr(XTX)1024.(16) 第一项使新投影接近目标,第二项限制偏离原权重;∥⋅∥F2 是元素平方和,I 是单位矩阵, N 为采集的特征行数,λgrid 为待选正则系数,按特征能量缩放。实现求解线性方程而非显式求逆,不使用反向传播;每轮重新采集候选的特征,并累积历轮的 XTX 和 XTY 后求解;X,Y 表示这些累积样本,V 投影权重保持不变。共享权重不直接接收动作序号,因此它依赖特征中已有的位置信息来近似额外旋转。

第三步:检查生成动作并调整拟合。初版在全部 18 层拟合 Q/K,两轮后拟合观测上与 teacher 的归一化动作 RMS 从 0.03694 降至约 0.00298。它检验的是最终动作,而非 Q/K 特征误差。改进版保留第 0 层,仅拟合第 1–17 层,相应 teacher 也仅在这些层修改 RoPE。它的考虑是:第 0 层输入尚未经过动作注意力混合,可能缺少让共享投影区分动作序号的信息。

第四步:在留出的观测上验证改进。Opus 5.5 从 12 条 demonstration 和 12 条历史执行轨迹中取 48 个观测拟合,另留 36 个时刻测试;时刻不重复,但来自同一批轨迹。三轮拟合后,共同测试上的进度比由初版约 1.17 增至 1.20,偏差由 1.26 降至 1.08 mm,jerk 比由 1.47 降至 1.37。Opus 5.5 因而保留 节奏加速编辑,接着检验修改强度及其与前缀修复的组合。

2.6 进一步施加参数约束,并与前缀修复合并验证#

Opus 5.5 用编辑强度 α 控制拟合改变量: W(α)=W0+αΔW,ΔW=Wfit(s=1.25)−W0.(17) α=0 为原版 Q/K,α=1 为完整 节奏加速编辑;它与拟合时的位置尺度 s=1.25 是不同参数。测试 α=0.25 至 1.5 时,进度先增加,随后饱和且偏差增大。将修改限制为秩 16、64、256 时,进度约为 1.06、1.10、1.16,低于完整 节奏加速编辑的约 1.20。

随后,它在 36 个相同测试观测上比较前缀修复、节奏加速编辑 与组合,并加入时间缩放和动作幅度缩放基线(系数均为 1.21445)。表 2 中路径与 jerk 指标纳入 35 个有效观测。chunk 跳变取旧计划前 4 步与新计划第 5–13 步拼接邻域内的最大相邻 TCP 步长,再取两臂较大值;它包含正常相邻动作位移。

表 2. 相同测试输入上的离线比较。各指标为中位数;进度、偏差和 jerk 有效输入数为 35,chunk 跳变为 36。进度 1.214 倍表示相同时间内沿原路线推进更多,不代表成功任务时间缩短 21.4%。

方法 路径进度比 路径偏差 (mm) jerk 比 chunk 跳变 (mm)
原版 1.000 — 1.000 44.223
仅前缀修复 1.000 0.178 1.004 5.822
仅 节奏加速编辑(α=1) 1.199 1.076 1.367 41.453
联合编辑 1.214 1.071 1.363 5.442
轨迹时间缩放 1.257 0.038 0.827 44.223
动作幅度缩放 1.054 4.870 1.217 53.529

组合候选同时增加了路径进度并减小 chunk 跳变,但 chunk 内 jerk 比升至 1.363。时间缩放的偏差与 jerk 更低,却保留了原版跳变;随机权重方向的路径偏差达到 24.05 mm、jerk 比为 31.07,未能保留原行为。Opus 5.5 最终选择联合编辑、α=1;由于未比较前缀修复+时间缩放,这不证明编辑优于所有后处理方案。

2.7 交付与研究开销#

Opus 5.5 检查保存、回滚与原生重载后,交付独立 checkpoint,共修改全模型 1.16% 的参数,8 个测试输入均得到有效输出。首轮研究用时 1 小时 50 分 42 秒,调用工具 193 次(Bash 163、Write 18、Read 8、其他 4),发起 187 次 API 请求。181 次有用量记录,合计输出 184,614 token,另有缓存写入 433,426、读取 36,783,281 token;缺失的 6 次请求不按零计入,缓存读取包含重复上下文。以上均不包含后续真机分析和本文编写。

3 我们后续的实验与分析#

我们随后检验实际任务用时与 chunk 跳变,并通过注意力区域干预和前缀处理对照分析内部作用。以下为我们补充的实验,不计入 Opus 5.5 首轮研究开销。

3.1 真机实验:任务用时与动作质量#

我们在放瓶子、投硬币和叠方块三个任务上比较原版 Training-Time RTC 与联合编辑版(α=1)。每个任务均采用相同的物体布局,每个权重与频率条件统计 3 次执行。 (1)放瓶子:权重编辑的收益在不同执行频率下持续存在。我们在此前的 30 Hz 测试之外,进一步以 35 和 40 Hz 比较两套权重。每个频率内,原版与编辑版采用相同设置、同一布局,各统计三次成功执行。用时从正式执行开始计至第四瓶在桶内放手,以真实采集时间戳计算。

这轮实验保持两套 checkpoint 不变,仅缩短动作点的执行间隔,不追加 RoPE 干预,也不重新拟合权重。32 步执行长度、6 步条件前缀和底层 100 Hz 控制循环保持不变;因此高频下同样步数覆盖的物理时间更短。

表 3. 相同布局下的执行频率对照。每个条件包含 3 次成功记录;用时为均值 ± 样本标准差。30 Hz 为此前批次,35/40 Hz 为后续实验。

频率 原版 RTC (s) 联合编辑 (s) 用时缩短
30 Hz 22.42±0.26 21.46±0.88 4.3%
35 Hz 19.43±0.12 17.99±0.77 7.4%
40 Hz 17.99±0.55 15.83±0.66 12.0%

提高执行频率让两套策略都更快,但编辑版在三档相同频率下始终保留额外收益。表 3 中,编辑版在 35 Hz 下的平均用时已经接近原版 40 Hz;两者都以 40 Hz 执行时,编辑版仍平均提前 2.15 s 完成。这支持权重编辑改变了策略生成动作的方式,其收益可以与执行频率提升叠加。这里的一致性指收益在三档频率下均存在,幅度并不相同。

三档频率下的 chunk 跳变均明显减小,汇总均值从 30.88 mm 降至 3.14 mm,降低 89.8%。我们沿用同一计算方式:在正式开始至第四瓶放手之间,定位计划切换前后相邻的命令 tick,经正向运动学计算 TCP 距离,取双臂较大值;先在每条轨迹内平均,再对每组 3 条轨迹等权平均。首次进入计划及经过空计划的切换不计入。该指标衡量命令的切换步长。表 4 列出各频率结果,汇总行对三档频率等权,不直接平均百分比。

表 4. 各执行频率下的平均 chunk 跳变。每个权重与频率条件包含 3 条成功轨迹,使用与完成时间相同的裁剪终点;三档合计每种权重 9 条。

频率 原版 RTC (mm) 联合编辑 (mm) 跳变降低
30 Hz 26.23 1.43 94.5%
35 Hz 33.39 3.09 90.7%
40 Hz 33.01 4.89 85.2%
三档等权平均 30.88 3.14 89.8%

更快的执行也伴随着更大的剩余跳变。编辑版在 30、35、40 Hz 下的平均 chunk 跳变从 1.43 增至 3.09、4.89 mm,相对原版的降幅由 94.5% 降至 90.7%、85.2%。因此,提高执行频率后仍明显优于同频率原版,但提速与动作连续性之间存在取舍。

此前 30 Hz 的逐次完成时间见表 5;表 6 进一步报告这六条 30 Hz 记录的动作质量。

表 5. 相同布局下 30 Hz 放瓶子任务的成功执行时间。每组 3 次,均值后为样本标准差;编号仅表示组内重复,不表示随机配对。

重复 原版 RTC (s) 联合编辑,α=1 (s)
1 22.69 20.45
2 22.17 21.87
3 22.41 22.05
均值 ± 标准差 22.42±0.26 21.46±0.88

编辑版平均提前 0.96 s 完成,时间缩短 4.3%。这是相同布局下各三次成功执行的比较,不能据此估计成功率变化。

在这六条 30 Hz 记录的同一完成区间内,我们在每次计划切换处计算相邻命令的 TCP 距离,取两臂较大值,再按每条轨迹统计并对组内三条轨迹取平均(表 6)。原版与编辑版分别包含 60、58 次切换,首次进入计划不计入。

表 6. 同六条成功记录、同完成区间内的动作质量。各行先按轨迹计算,再对每组 3 条轨迹等权平均;“最大值”是每条轨迹最大值的组均值。

指标 原版 RTC 联合编辑 降低比例
平均 chunk 跳变 (mm) 26.23 1.43 94.5%
试验内跳变 P95 的均值 (mm) 43.57 4.53 89.6%
试验内最大跳变的均值 (mm) 51.49 5.87 88.6%
命令 jerk P95 (m/s3) 1040.40 234.78 77.4%
平均末端跟踪误差 (mm) 19.59 19.17 2.1%

平均 chunk 跳变降低 94.5%,末端跟踪误差基本保持。完整命令轨迹按 30 Hz 三阶差分计算的 jerk P95 也下降 77.4%;它包含切换处的改善,与仅统计 chunk 内部的离线 jerk 不同。

(2)投硬币:提速主要发生在夹取后的搬运阶段。我们以实测夹爪的持续闭合、张开划分动作阶段。表 7 显示,从左手闭合到交接放开的总用时由 5.85 s 降至 4.64 s,缩短 20.7%;其中,左手闭合至右手闭合的搬运阶段缩短 22.1%,开始到夹取及交接放手的用时基本不变。

表 7. 相同布局下投硬币任务的分阶段用时:原版与编辑版各 3 次,表中为各组均值。阶段边界来自实测夹爪状态;开始时刻为正式执行的首个有效计划 tick。最后一行是中间两阶段的合计。

阶段 原版 (s) 编辑版 (s) 用时缩短
接近与夹取:开始至左手闭合 8.034 8.039 −0.1%
搬运至交接:左手闭合至右手闭合 5.451 4.245 22.1%
交接放手:右手闭合至左手张开 0.399 0.396 0.7%
夹取后至交接放开(合计) 5.849 4.641 20.7%

这里的 20.7% 表示夹取后至交接放开的阶段用时缩短,与瓶子实验的整项任务完成时间分开报告。

(3)叠方块:没有观察到明显提速。两组各 3 次测试最终均成功,成功数同为 3/3。其中,原版第 2 次执行在堆叠失败后重新抓取并完成任务,因此总用时较长,为 28.27 s。表 8 保留全部六次执行的完成时间;为比较无需重试时的执行速度,我们排除这次记录后计算均值。原版其余 2 次与编辑版 3 次的平均完成时间分别为 19.46、19.28 s,仅缩短 0.19 s(约 1.0%),且单次用时相互重叠。

表 8. 相同布局下叠方块任务的完成时间。从正式执行开始计时,到视频确认最终方块放开且由下方堆叠支撑为止。† 表示堆叠失败后重试成功:保留该次结果,但不纳入下方的速度比较均值。编号仅表示组内重复。

重复 原版 RTC (s) 联合编辑(s)
1 19.42 19.56
2 28.27† 19.00
3 19.50 19.26
均值(排除重试) 19.46(n=2) 19.28(n=3)
最终成功数(全部测试) 3/3 3/3

这些真机结果表明,权重编辑在我们的任务中确实取得了收益:放瓶子更快且 chunk 跳变更小,投硬币的搬运阶段也有所加快。但这仍是一次初步尝试,提速幅度有限。这与第 2.3 节的假设及离线结果相呼应:模型学到的动作位置与位移关系可能提供调节动作节奏的入口。

3.2 在参数空间修复前缀一致性问题#

出人意料的是,前缀修复让我们注意到了一个在 Training-Time RTC(TT-RTC)官方公开代码中未处理的 bug:实际延迟短于预设前缀时,被最后一次积分改写的条件动作仍可能进入执行。我们首先简单介绍什么是 TT-RTC。

TT-RTC 要解决的是:机器人在等待下一段 chunk 推理完时,如何继续运动,并顺畅切换到新 chunk。图 6 顶行是上一个 chunk 剩余的动作 A1,A2,…。模型从 A₁ 开始进行下一段动作的推理时,机器人继续执行当前 chunk;我们把预计在等待期间执行的前 6 步 A1–A6 作为条件(prefix),让模型生成接在后面的新动作 B7,B8,…。TT-RTC 官方代码的固定延迟仿真使用相同的条件长度与延迟。以图 6(a) 的 6 步为例,旧 chunk 执行到 A6 后,新结果恰好返回。程序丢弃新输出的前 6 步,从 B7 开始执行,完成 chunk 切换 [4], [5]。
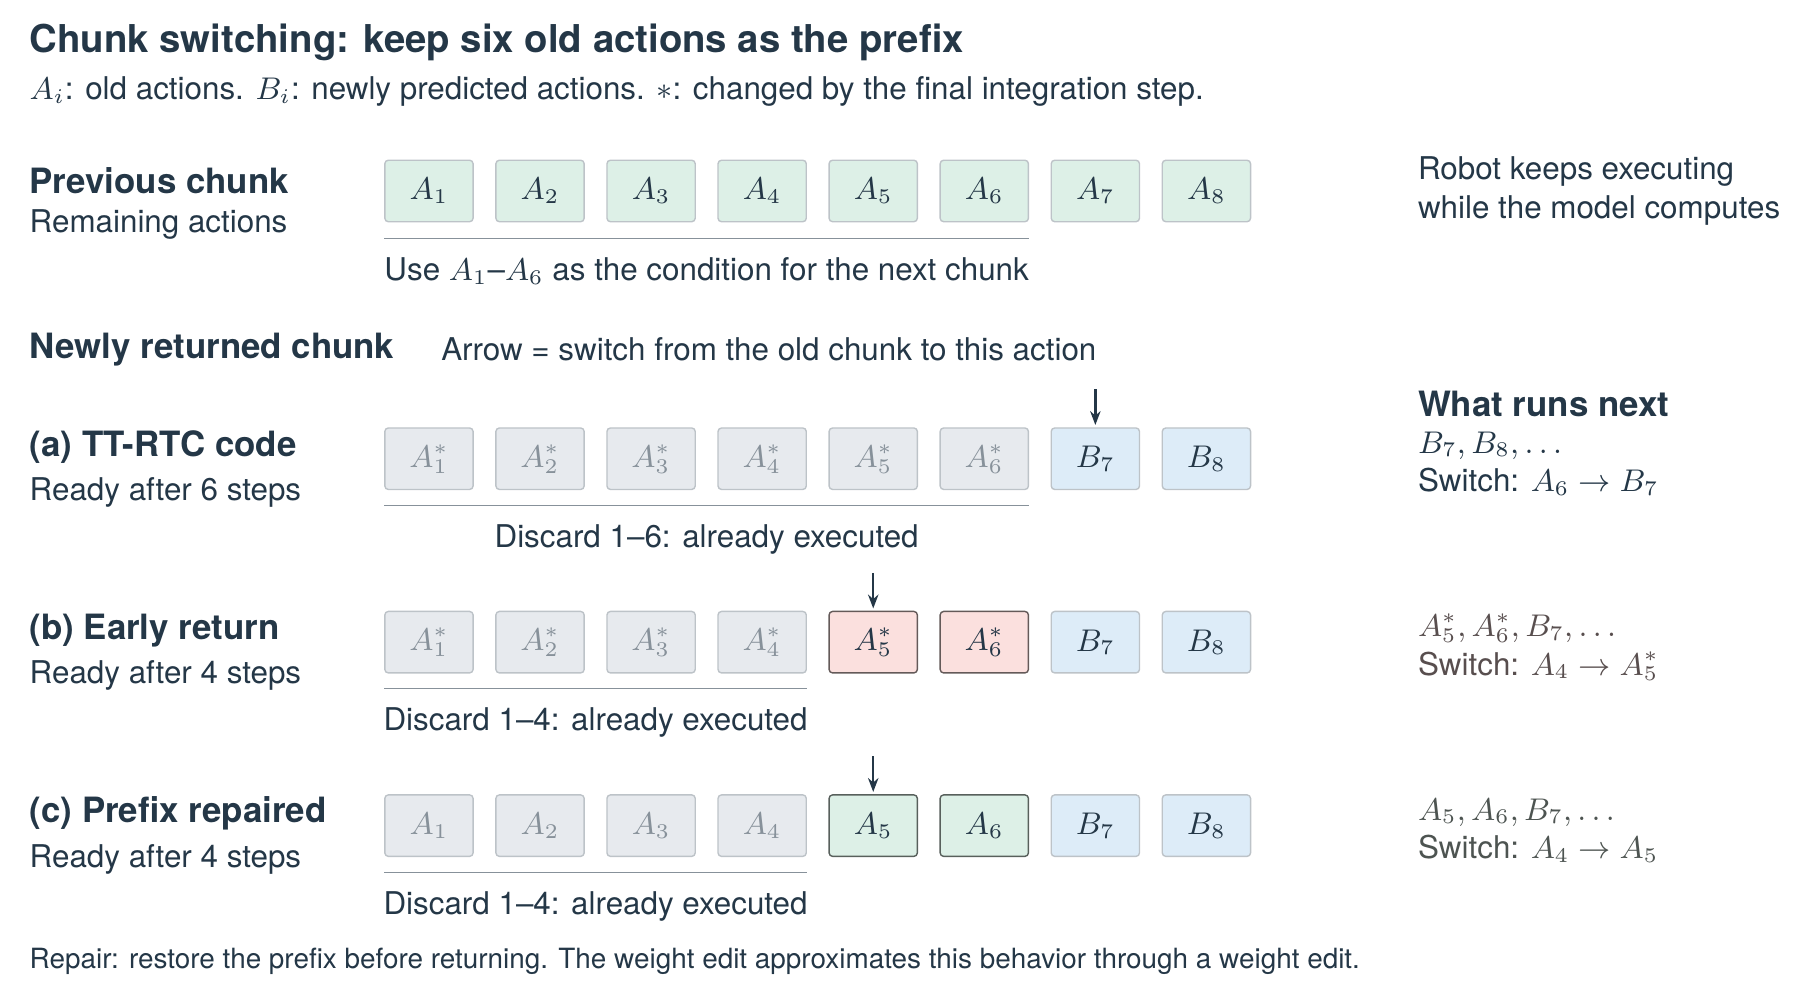
从旧 chunk 切换到新 chunk。顶行是计算开始时旧计划剩余的动作,前 6 步被用作条件。下方三行是新返回的动作序列,箭头标出切换后从哪里开始执行;灰色位置会被丢弃,星号表示最后一次采样积分留下的改动。(a) 等待 6 步:旧计划执行到 \(A_6\) ,切换到 \(B_7\) 。(b) 只等待 4 步:旧计划执行到 \(A_4\) ,却切换到被改写的 \(A_5^*,A_6^*\) (红色)。(c) 修复后,同样在 \(A_4\) 后切换,但接上的是保持原样的 \(A_5,A_6\) (绿色),再执行新动作 \(B_7,B_8\) 。
图 6. 从旧 chunk 切换到新 chunk。顶行是计算开始时旧计划剩余的动作,前 6 步被用作条件。下方三行是新返回的动作序列,箭头标出切换后从哪里开始执行;灰色位置会被丢弃,星号表示最后一次采样积分留下的改动。(a) 等待 6 步:旧计划执行到 A6,切换到 B7。(b) 只等待 4 步:旧计划执行到 A4,却切换到被改写的 A5∗,A6∗(红色)。(c) 修复后,同样在 A4 后切换,但接上的是保持原样的 A5,A6(绿色),再执行新动作 B7,B8。

图 6(b) 展示了结果提前返回时的问题。模型只计算了 4 个动作步的时间,机器人也只执行到旧 chunk 的 A4,接下来仍需要 A5,A6。然而,条件前缀在 flow matching 采样中仍参与积分更新。以我们使用的 10 次采样迭代为例,第 1–9 次积分对前缀的改动,都会在下一轮计算前被给定的旧动作替换;第 10 次积分后却直接返回,没有再替换一次。因此,新结果中留下的可能是 A5∗,A6∗,而不是原计划的 A5,A6。此时切换 chunk,机器人就会接到两个被改写的动作,产生跳变。TT-RTC 官方代码在图 6(a) 的设定下会丢弃全部前缀,因此没有暴露这一问题。

对于需要 IK 的部署,为覆盖求解时延波动,我们通常会保守地预留更长的 prefix。延迟波动越大,这个预留长度与某次实际延迟的差距也可能越大;一旦结果提前返回,就会留下更多仍需执行的条件动作。OpenWAM [6] 原版使用 i2rt 封装的 Mink 微分 IK,迭代求解二次规划(QP);包含 IK 的动作解码耗时中位数为 22.9 ms,最高 921.2 ms。随后采用的 DLS gate 根据雅可比矩阵最小奇异值调节运动正则、限制关节变化,耗时仍从中位数 49.3 ms 到最高 177.7 ms。

图 6(c) 展示了修复后的切换:即使在 A4 后拿到新结果,接下来执行的仍是原计划的 A5,A6。Opus 5.5 的前缀修复让这些条件动作对应的采样更新量接近零,避免最后一次积分改写它们。它修改的是动作专家最后一个归一化层的时间调制权重 final_norm_1.Dense_0.kernel。在当前设置下,其效果几乎等价于返回前执行 actions[:6] = condition[:6],即把前 6 步重新替换为给定的旧动作;Opus 通过修改参数近似实现了这一步。

我们随后用相同的 36 个观测(12 个本地 demonstration、24 个历史 rollout 观测)补充对照,固定随机种子和采样步数,比较缩短条件、仅使用前缀修复、直接恢复前缀三种处理,均不包含 节奏加速编辑。

表 9. 前缀处理对照:36 个相同观测,假设实际裁剪 4 步。切换点步长为旧计划第 4 步至新计划第 5 步的 TCP 距离,取双臂较大值,再取样本中位数。后续动作差异为第 7–38 步、12 个关节相对原版的 RMS,取样本均值。

方法 切换点步长 (mm) 后续动作差异 (rad)
原版,6 步条件 19.158 0.000000
原版,4 步条件 4.930 0.002228
仅前缀修复,6 步条件 1.798 0.000375
代码修复,返回前恢复 6 步 1.885 0.000000

表 9 显示,相对原版的 19.16 mm,前缀权重修复与直接恢复前缀的代码修复,分别将切换点步长中位数降至 1.80、1.88 mm,后续动作变化也很小。这支持两者在前缀修复上的近似等效。缩短为 4 步条件也能改善当前对照,但不能消除实际延迟短于条件长度时的同类问题。

Opus 通过修改时间调制权重,使条件前缀的更新量接近零,在参数空间修复了官方公开代码未处理的这一 bug:实际延迟短于预设 prefix 时,被采样更新改写的条件动作仍可能进入执行序列。对于需要 IK、必须为延迟波动预留余量的部署,这项前缀保护尤其重要。我们没有指定这一缺陷;Opus 在研究中主动发现它,并在不改推理代码的约束下给出了参数层面的修复。

3.3 机制分析:哪些注意力变化保留了进度收益#

我们在相同的 8 个瓶子任务观测上比较原版、直接 RoPE teacher 与 节奏加速编辑,固定初始噪声、RTC 条件和采样步数,不叠加前缀修复。首先,节奏加速编辑的上下文注意力与 teacher 更接近:分布距离 JSD 为 0.00173,低于其与原版的 0.00792(越低越接近)。这支持拟合保留了位置干预的部分内部效果。
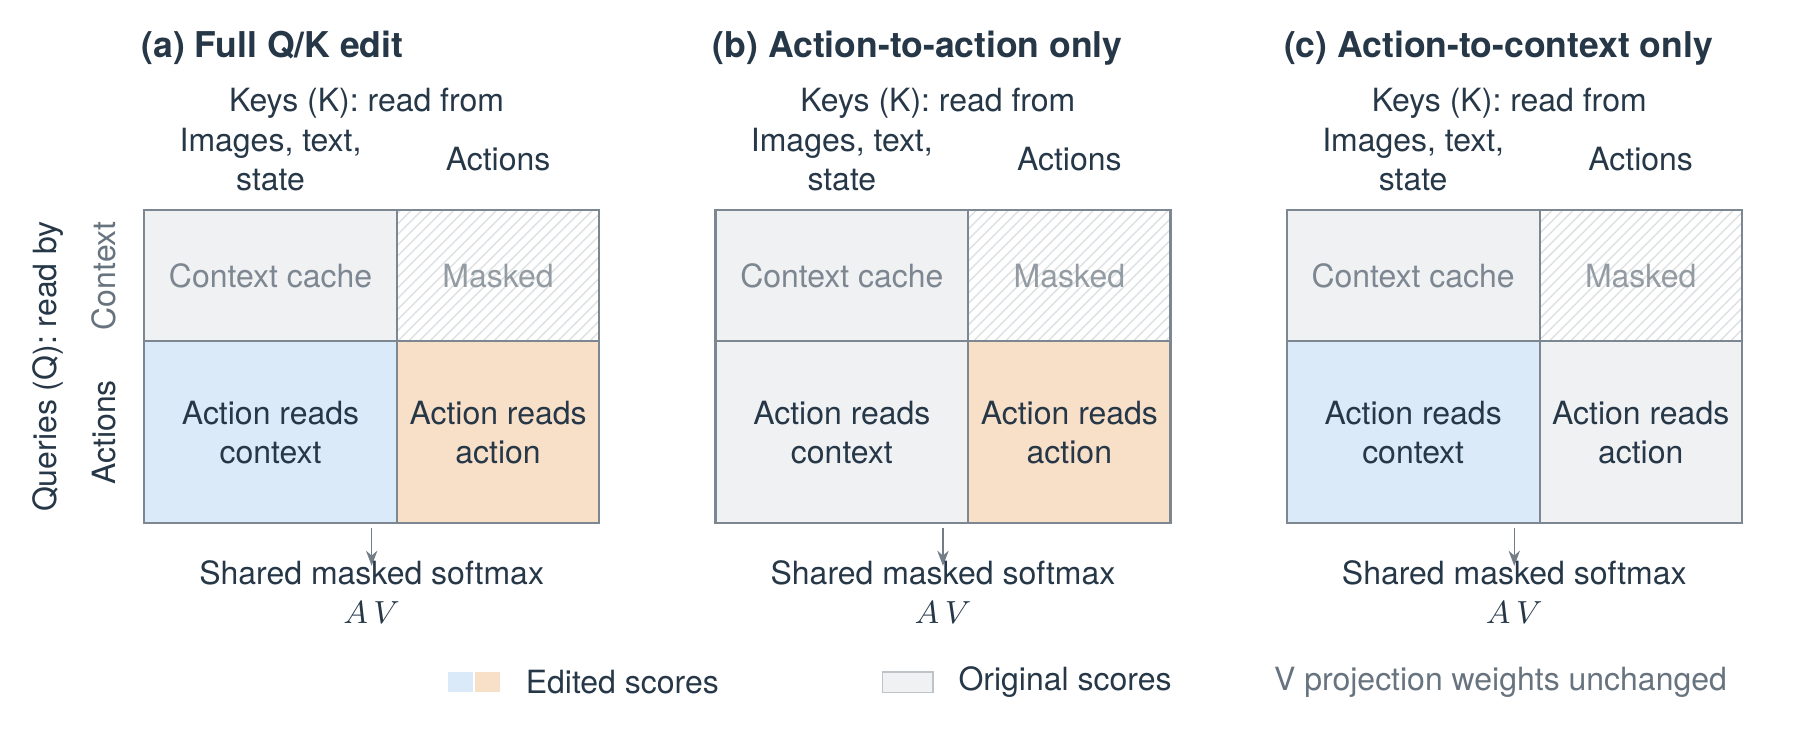
统一带掩码 softmax 之前的注意力分数干预。行是 query,列是 key。蓝色:动作读取上下文;橙色:动作读取动作;灰色:原版分数。右上角被掩码屏蔽。颜色标记干预区域,不代表实测数值大小。
图 7. 统一带掩码 softmax 之前的注意力分数干预。行是 query,列是 key。蓝色:动作读取上下文;橙色:动作读取动作;灰色:原版分数。右上角被掩码屏蔽。颜色标记干预区域,不代表实测数值大小。

图 7 标出两个区域:右下角是动作读取动作,左下角是动作读取图像、文本和状态。在每层当前同一份隐藏特征 X 上,分别用原版(r=0)和 节奏加速编辑(r=E)的 Q/K 权重,按式 (7) 计算投影并施加原始 RoPE,得到 softmax 前的分数: Lijr=(Qir)TKjrd,Lr=[Lctxr∣Lactr],r∈{0,E}.(18) 其中 i 为动作 query,j 为 key,d=256;ctx 表示图像、文本和状态,act 表示动作。上下文缓存 K 保持不变。两种区域干预分别为: Aact-only=softmax([Lctx0∣LactE]+M),Actx-only=softmax([LctxE∣Lact0]+M).(19) M 为原始注意力掩码(可读取位置为 0,屏蔽位置为 −∞)。组合分数后统一归一化,再计算 AV 并继续前向传播;V 投影权重保持不变。由于 softmax 分母共享,改变一块分数也可能改变另一块的概率。

表 10. 注意力路径干预对预测动作的影响,8 个输入的中位数。进度沿原路径计算,分别取第 21、37 步;所有变体均使用同一批手臂,按原版预测累计移动至少 15 mm 的条件选择。前缀修复均关闭,jerk 为 chunk 内指标。这些是离线计划的几何量,不是实测完成时间。

干预 第 21 步进度比 第 37 步进度比 偏差 (mm) jerk 比
原版 1.000 1.000 — 1.000
直接 RoPE teacher 1.203 1.101 1.012 1.105
完整 节奏加速编辑 1.227 1.140 1.028 1.289
仅动作 key 分数 1.178 1.087 1.100 1.249
仅图像与 prompt/state 分数 1.057 1.039 0.484 0.981

表 10 显示,第 37 步的进度比由完整 节奏加速编辑的 1.140 变为仅动作间干预的 1.087、仅上下文干预的 1.039。动作之间的分数干预保留了较多离线进度收益。

结语#

我们本以为,这会是一次 magic:Claude 凭直觉修改几处权重,机器人就能执行得更快。然而事实并非如此。我们认为,这次 Weight Editing 的成功,本质上来自 Frontier Model 的 AutoResearch 能力:理解机制、发现问题、检验假设,并根据失败调整方向。对参数空间的理解使修改成为可能,而研究过程让它找到了值得实现的修改。

这也引出了一个更重要的问题:在 Robotics 知识逐渐被 Frontier Model 内化的时代,下一代、甚至未来几代模型,会如何改变我们提出问题、验证想法和推进研究的方式?这个案例还无法回答,但它让这些问题变得具体,也让我们对接下来会发生什么充满期待。当模型能够承担更多探索和验证工作,我们需要更认真地思考:如何把 Robotics 需求抽象提炼成适合 AutoResearch 的研究任务?以及如何找到更有意义的 scientific or engineering problem?

希望本文能揭开 Frontier Models for Robotics Research 的一角。

参考文献

  1. Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab. Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights. MIT CSAIL, 2026. https://rikiyat.github.io/blog/weight-space-programming/.

  2. Physical Intelligence et al. π0.5: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054, 2025. https://arxiv.org/abs/2504.16054.

  3. Jianlin Su et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. arXiv:2104.09864. https://arxiv.org/abs/2104.09864.

  4. Kevin Black, Allen Z. Ren, Michael Equi, Sergey Levine. Training-Time Action Conditioning for Efficient Real-Time Chunking. arXiv:2512.05964v2. https://arxiv.org/html/2512.05964v2.

  5. Physical Intelligence. real-time-chunking-kinetix, commit 9296f31d62d5. https://github.com/Physical-Intelligence/real-time-chunking-kinetix. 本文核对 src/model.py 与 src/eval_flow.py。

  6. Yuran Wang et al. OpenWAM: An Open, Modular Exploration Towards Systematic World-Action Model Pretraining. arXiv:2609.07398, 2026. https://arxiv.org/abs/2609.07398.

BibTeX

@misc{gong2026roboticsweightediting,
  author = {Gong, Ziyang and Zheng, Kaifeng and Huang, Yingrui and
            Chen, Wendi and Tian, Jiaguo and Yang, Junkai and
            Liu, Minghuan and Yang, Zhenjie},
  title = {{We Asked Opus-5.5 to Edit $\pi_{0.5}$'s Weights.
            AutoResearch Made It Happen.}},
  year = {2026},
  url = {https://cuzyoung.github.io/robotics-weight-editing/en/}
}

原始研究 Prompt
下载英文 TXT ↓

# Research Task: Autonomous Weight-Space Acceleration for π₀.₅

## Background

We currently have two trained VLA policies:

1. π₀.₅ Latest
2. π₀.₅ Training-Time RTC

Both policies can already perform some manipulation tasks on a real robot, but there is still room to improve their execution speed.

I would like to explore the **Weight-Space Programming** approach recently proposed by MIT: having a frontier model directly understand and modify neural network weights to improve a VLA policy's real-world execution speed without conventional gradient-based training.

Reference:

https://rikiyat.github.io/blog/weight-space-programming/

This is an exploratory Weight-Space Programming research project, rather than a conventional inference acceleration, runtime optimization, or fine-tuning task.

**The core goal is to make the robot's actions noticeably faster while preserving the original policy's motion smoothness, stability, and task success rate.**

The motion does not need to be smoother than the original, but the speed improvement must not introduce noticeable stuttering, shaking, abrupt stops, or discontinuities.

## Objective

**Can we directly accelerate a pretrained VLA policy through weight-space editing, without gradient-based training, while preserving its original motion smoothness and task performance?**

The aim is to make the policy generate more efficient action trajectories by directly analyzing and modifying π₀.₅'s weights.

Specific goals:

1. **Faster Execution**: Significantly reduce the time the real robot needs to complete a task.
2. **Preserved Smoothness**: Keep motion smoothness at least close to that of the original policy, without noticeably increasing stuttering, shaking, or action discontinuities.
3. **Preserved Success Rate**: Preserve or improve the original task success rate as much as possible.
4. **Minimal Weight Modification**: Modify as few parameters as possible.
5. **No Runtime Overhead**: Introduce no additional inference modules or deployment latency.
6. **Generalization**: Investigate whether the acceleration generalizes across tasks, initial states, and object positions.

Prioritize improvements in actual robot execution speed over simply changing action magnitudes.

## Phase 1: Autonomous Investigation

Begin by independently exploring the current codebase, model architecture, and experiment records.

Locate:

- The model weights and configuration for π₀.₅ Latest.
- The model weights and configuration for π₀.₅ Training-Time RTC.
- Recent real-robot execution logs.
- The corresponding robot states, action trajectories, execution times, task success rates, and videos.
- The current policy's inference pipeline, action expert architecture, and flow matching implementation.
- The current runtime's action chunking, RTC, action interpolation, smoothing, and execution mechanisms.

Prioritize Training-Time RTC.

Focus on the following questions:

- Which stages account for most of the current policy's task execution time?
- Are there unnecessary pauses, waits, or periods of slow motion?
- Are there action paths that could be shortened?
- Are there velocity discontinuities between action chunks?
- Is execution speed primarily limited by the policy's predictions or by the runtime/controller?
- Is the current policy already close to the hardware's safe motion speed limits?
- Can execution efficiency be improved by changing the distribution of actions produced by the policy?

Pay particular attention to the following:

**Do not equate inference latency reduction with robot execution acceleration.**

Clearly distinguish between:

1. Model Inference Latency
2. Action Chunk Generation
3. Runtime Scheduling / Execution
4. Robot Motion Duration
5. End-to-end Task Completion Time

Our primary goal is to improve items 4 and 5.

If the main bottleneck lies in the runtime, report that honestly. However, this study should still prioritize exploring the potential of weight-space editing.

## Phase 2: Safe Model Duplication

Before running any experiments:

1. Locate the original Training-Time RTC checkpoint.
2. Create a separate experimental copy.
3. Record the original checkpoint's hash, configuration, and version.
4. Apply all weight edits only to the experimental copy.
5. Establish mechanisms for saving, loading, comparing, and rolling back weight patches.
6. Write all new experiment outputs to separate directories.

**Never overwrite, delete, or modify any original model weights, configurations, experiment records, or data.**

Do not modify π₀.₅ Latest for now.

Consider transferring the approach to Latest only after making clear progress on Training-Time RTC.

If loading the model could write to the original checkpoint, eliminate that risk first.

## Phase 3: Weight-Space Investigation

Follow the research approach described in MIT's Weight-Space Programming work:

**Inspect → Hypothesize → Edit → Evaluate → Iterate**

You may independently design analysis tools, including:

- Weight Inspection
- Activation Inspection
- Action Expert Investigation
- Flow Matching Trajectory Analysis
- Layer-wise Sensitivity Analysis
- Sparse Weight Editing
- Low-rank Weight Editing
- Forward-only Parameter Search
- Action Distribution Analysis
- Motion Smoothness Analysis

Focus on the following questions:

### 3.1 Can we identify speed-related directions in weight space?

Can we identify parameter directions in the action expert or other relevant modules that affect the robot's motion speed?

For example:

- Do certain parameters affect action magnitudes?
- Do certain parameters affect slow phases of a trajectory?
- Do certain parameters affect the temporal distribution of action chunks?
- Do certain parameters affect acceleration and deceleration behavior?

Try to identify weight-space directions that change execution speed while preserving the action targets and overall trajectory shape as much as possible.

### 3.2 Can we accelerate motion without introducing jerk?

Can localized weight edits make the policy generate faster trajectories that remain continuous?

We would like to achieve:

\[
T_{\mathrm{edited}} < T_{\mathrm{original}}
\]

while satisfying:

\[
J_{\mathrm{edited}}
\approx
J_{\mathrm{original}}
\]

where:

- \(T\) denotes actual task completion time.
- \(J\) denotes trajectory jerk or another measure of motion smoothness.

Note that the absolute value of jerk depends on motion speed and timescale, so raw jerk values alone cannot determine whether motion is smoother.

Evaluate velocity, acceleration, jerk, action discontinuities, and actual execution behavior together.

### 3.3 Can we preserve task semantics while accelerating execution?

The policy should still complete the original manipulation tasks correctly.

For example:

- Grasp locations must not shift noticeably as a result of acceleration.
- The robot must still decelerate appropriately when approaching a target.
- Contact with objects must not cause pronounced impacts.
- The timing of gripper opening and closing must remain appropriate.
- Task completion detection must not trigger prematurely.

**We are aiming for more efficient motion, rather than simply multiplying every action by a factor greater than 1.**

## Phase 4: Autonomous Weight Editing

Independently perform weight-space editing on the separate experimental copy of Training-Time RTC.

You may explore different approaches, including:

- Sparse Parameter Modification
- Low-rank Weight Updates
- Selected Layer Editing
- Action Expert Weight Surgery
- Behavior-related Circuit Editing
- Forward-only Weight-Space Search

You do not need to commit to a particular method in advance.

You may propose new editing strategies based on the model architecture, weight distributions, and experimental results.

However, you must follow this restriction:

**Do not use backpropagation, gradient descent, optimizer steps, LoRA fine-tuning, or any other gradient-based training methods.**

You may:

- Read model parameters.
- Analyze activations.
- Run forward passes.
- Compare the action outputs of different weight patches.
- Use gradient-free search methods.
- Iterate independently based on experimental feedback.

For every edit, record:

1. The layers/modules modified.
2. The number and percentage of parameters modified.
3. The exact form of the weight patch.
4. Action predictions before and after the edit.
5. Velocity, acceleration, and jerk before and after the edit.
6. Estimated task completion time before and after the edit.
7. Potential effects on task success rate and motion stability.

Do not assume that any particular weight-editing method will work.

Failure is acceptable; use failed experiments to adjust the research direction.

## Phase 5: Evaluation

Prioritize validation using existing experimental records and offline data.

If a simulation environment is available, you may also perform closed-loop evaluation.

Do not automatically start real-robot execution without my explicit confirmation.

### 5.1 Baselines

Compare at least the following:

1. Original Training-Time RTC
2. Original Policy + Action Scaling
3. Original Policy + Trajectory Time Scaling
4. Random Weight Editing
5. Proposed Weight-Space Editing

Action Scaling and Trajectory Time Scaling are only control experiments and must not be presented as Weight-Space Programming.

You may also independently add other reasonable baselines for speed optimization.

### 5.2 Metrics

**Execution Efficiency**

- End-to-end Task Completion Time
- Robot Motion Duration
- Average EEF Velocity
- Peak EEF Velocity
- Idle / Pause Duration
- Trajectory Length

**Motion Smoothness**

- Velocity Continuity
- Acceleration Continuity
- Jerk
- Action Chunk Boundary Discontinuity
- Oscillation Frequency
- Unexpected Stops

**Task Performance**

- Task Success Rate
- Final Position Error
- Grasp / Placement Accuracy
- Collision Rate
- Contact Stability

**Weight Editing**

- Number of Modified Parameters
- Percentage of Modified Parameters
- Weight Patch Norm
- Inference Latency
- Regression on Other Tasks

### 5.3 Success Criteria

Prioritize exploring whether the following can be achieved:

- Reduce task completion time by **20%–30%**.
- Keep the task success rate at least as high as the original, allowing for statistical uncertainty.
- Maintain motion smoothness close to the original.
- Introduce no noticeable new stuttering, oscillations, or unexpected stops.
- Do not increase model inference latency.
- Require no additional runtime controller.

20%–30% is an exploratory target and must not be treated as a mandatory requirement.

Even if the result is only a stable 5%–10% speedup, retain it as long as the improvement can be shown to come from weight editing and there is no noticeable performance degradation.

Without sufficient closed-loop evaluation, do not directly interpret improvements in offline action predictions as improvements in real execution speed.

## Phase 6: Weight-Space Speed Control

If the preceding experiments make progress, you can further explore a question with greater research value:

**Can we discover a controllable speed direction in the weight space of a pretrained VLA?**

Suppose there is a parameter direction:

\[
\Delta\theta_{\mathrm{speed}}
\]

Can we then use:

\[
\theta'=\theta+\alpha\Delta\theta_{\mathrm{speed}}
\]

to control the policy's motion speed?

For example:

| α | Expected Behavior |
|---|---|
| 0 | Original Policy |
| 0.25 | Slightly Faster |
| 0.5 | Moderately Faster |
| 1.0 | Significantly Faster |

Validate the following:

1. Does speed vary approximately monotonically with α?
2. Do different values of α preserve similar motion trajectories?
3. Is there a noticeable trade-off between speed and smoothness?
4. Can this direction generalize to different tasks?
5. Is there a safe and stable range of α?

Finding a controllable, reusable speed direction would have greater research value than simply obtaining a faster checkpoint.

## Research Principles

This is an open-ended autonomous research task.

You may independently:

- Read the code and model architecture.
- Analyze weights and activations.
- Write experimental scripts.
- Run model inference.
- Construct and test weight patches.
- Design new diagnostic experiments.
- Revise research hypotheses.
- Try different weight-space editing methods.

You do not need to ask me for confirmation at every step.

However, you must ensure the following:

1. Keep the original checkpoint and experimental data completely safe.
2. Do not use gradient-based training.
3. Do not disguise runtime optimization as weight editing.
4. Do not disguise simple action scaling as a new research method.
5. Do not sacrifice task success rate or motion stability to improve speed.
6. Do not start a real robot without authorization.
7. All conclusions must be supported by reproducible experimental evidence.

Pay particular attention to the following:

**Greater action magnitudes do not mean faster task completion.**

If the robot's actuators have speed limits, control delays, or action saturation, simply scaling up actions may lead to more severe oscillations and task failures.

You must assess whether the speed improvement holds by examining the actual execution pipeline.

## Expected Deliverables

The desired final deliverables are:

1. A separate Training-Time RTC checkpoint with edited weights.
2. The corresponding weight patch file and reproducible code.
3. A comparison of action trajectories from the original and modified policies.
4. Evaluation results for execution speed, motion smoothness, and task performance.
5. Research conclusions on whether weight-space acceleration is effective.
6. If it is effective, an analysis of which parameter modifications caused the speed changes.
7. If it is ineffective, an analysis of the technical bottlenecks and directions worth exploring next.
8. If a controllable speed direction is discovered, the corresponding parameter patch and control experiments.

Do not make parameter modifications unsupported by evidence merely to deliver a modified checkpoint. If no effective result can be obtained, report that honestly.

## Final Instruction

**Start with Training-Time RTC.**

Autonomously investigate the model architecture, weights, action generation process, and existing execution logs.

Explore whether direct weight-space editing can produce faster robotic motion while preserving the original policy's smoothness and task performance.

Preserve all original artifacts.

Do not overwrite any existing checkpoint.

Do not use gradient-based training.

Do not modify the production runtime or robot controller.

Iterate based on evidence, and prioritize measurable improvements over speculative claims.

**The ultimate goal is not merely to make the robot move faster, but to discover whether execution speed can be directly programmed into the weight space of a pretrained VLA.**